Mémoire et performance
Un jeu dispose d'une image pour tout faire : 1/50 ou 1/60 de seconde. Et sa mémoire se compte en kilo-octets. Ce chapitre rassemble ce qu'il faut savoir pour écrire un programme rapide et économe, sur des processeurs aussi différents que le 6502, le Z80 et le 68000. Tous les chiffres ont été mesurés.
Le budget d'une image
Tout ce qu'un jeu fait pour une image (lire la manette, déplacer les personnages, tester les collisions, mettre à jour l'écran, jouer la musique) doit tenir dans le temps d'une image. Au-delà, le jeu ralentit.
| Machine | Processeur | Images par seconde | Cycles par image |
|---|---|---|---|
| Commodore 64 (PAL) | 6510 à 0,98 MHz | 50 | 19 656 |
| PC Engine | HuC6280 à 7,16 MHz | 60 | environ 119 000 |
| NES | 2A03 à 1,79 MHz | 60 | environ 29 800 |
| Amstrad CPC | Z80 à 4 MHz (effectif : environ 3,3) | 50 | 80 000 états, environ 20 000 instructions courtes |
| Mega Drive | 68000 à 7,67 MHz | 60 | environ 128 000 |
Les cycles ne se comparent pas directement d'un processeur à l'autre : une instruction en prend 2 à 7 sur un 6502, 4 à 23 sur un Z80, 4 à plus de 100 sur un 68000. Ce qui compte, c'est la part de l'image que prend un calcul.
Mesurer avant d'optimiser
On optimise ce qui coûte, pas ce qu'on croit coûteux. La technique la plus simple, et la plus utilisée par les programmeurs de l'époque : changer la couleur de la bordure avant un calcul, et la remettre après. L'écran se dessine ligne par ligne pendant que le programme travaille : la hauteur de la bande colorée montre le temps passé.
// Mesurer avec la bordure : 20 divisions par 40 à chaque image (Commodore 64)
architecture commodore.c64;

addlib event.irq;
addlib vic.base;

unit {
    uint resultat;

    main() {
        vic.setBackgroundColor(vic.BLACK);
        while (1) {
            irq.waitFrame();                    // attendre le début d'une image
            vic.setBorderColor(vic.RED);        // la bordure en rouge pendant le calcul...
            for (uint i = 0; i < 20; i++) {
                .resultat = (i + 1000) / 40;
            }
            vic.setBorderColor(vic.BLACK);      // ... puis en noir
        }
    }

    interrupt -> irq {
    }
}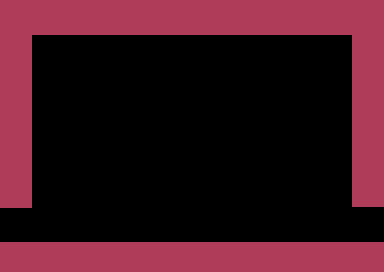
La même boucle, à un nombre près, prend presque toute l'image dans un cas, et une trentaine de lignes dans l'autre. Les sections suivantes expliquent pourquoi.
D'autres outils complètent la bordure :
- l'assembleur généré,
asm/main.asm, montre ce que devient chaque ligne ; - le rapport de compilation et le diagramme du projet de Simple8 IDE donnent la place occupée par chaque unit, en ROM, en RAM et en page zéro ;
- un débogueur d'émulateur (Geargrafx, VICE, Mesen…) compte les cycles
entre deux points, grâce à la table des symboles,
main.sym.
Choisir ses types selon le processeur
Au chapitre 3, la règle était : le plus petit type qui suffit. Elle est juste sur un 6502, mais chaque processeur a ses préférences. Voici le coût d'une addition, d'une multiplication et d'une division entre deux variables, mesuré sur les trois familles de processeurs, dans leurs propres unités.
6502 (C64, NES, PC Engine) : un vrai 8 bits
| Cycles | ubyte | uint | ulong |
|---|---|---|---|
| addition | 6 | 9 | 18 |
| multiplication | 195 | 197 | 693 |
| division | 768 | 770 | 3 145 |
Le 6502 calcule 8 bits à la fois : chaque octet de plus coûte. Il ne sait ni multiplier
ni diviser : ces opérations sont de petits programmes, et un ulong les rend 3 à
4 fois plus lentes. Préférez ubyte, puis uint ;
réservez ulong aux grands nombres.
Z80 (Amstrad CPC, MSX, Master System) : un 8 bits qui aime le 16 bits
| États (T-states) | ubyte | uint | ulong |
|---|---|---|---|
| addition | 77 | 64 | 383 |
| multiplication | 1 037 | 1 024 | 8 047 |
| division | 2 126 | 2 114 | 12 200 |
Surprise : sur Z80, un uint n'est pas plus lent qu'un
ubyte, et même un peu plus rapide pour l'addition. Le Z80 a des paires de
registres de 16 bits (HL, DE, BC) et une addition
16 bits (ADD HL,DE) : un ubyte, lui, doit d'abord être étendu.
En revanche, il n'a rien pour 32 bits : un ulong coûte 6 à 8 fois plus.
Sur Z80, uint est le type naturel ; ulong est
à éviter dans les boucles. Le SM83 de la Game Boy, cousin du Z80, a lui aussi des paires
de registres de 16 bits.
Le Z80 en pratique. Ses instructions sont plus longues que celles du
6502 (4 états au minimum, souvent 7 à 19), mais il en fait plus à la fois. Il n'a pas de
page zéro : toute la mémoire s'atteint de la même façon. Ses registres d'index
IX et IY sont pratiques mais lents (19 états par accès). Et sur l'Amstrad CPC, le circuit vidéo arrondit
chaque instruction à un multiple de 4 états : la vitesse réelle est d'environ 3,3 MHz
plutôt que 4.
68000 (Mega Drive, Amiga) : un processeur 16/32 bits
| Cycles | ubyte | uint | ulong |
|---|---|---|---|
| addition | 16 | 16 | 20 |
| multiplication | 72 | 60 | 278 |
| division | 238 | 238 | 432 |
Le 68000 a des registres de 32 bits : une addition coûte presque le même prix pour les
trois tailles. On pourrait croire que long est alors le type naturel. Ce n'est
pas le cas, pour deux raisons :
- ses instructions de multiplication et de division ne travaillent que sur
16 bits (
MULU: 16 × 16 bits ;DIVU: 32 bits divisés par 16). Unulongmultiplié par unulongdemande plusieurs multiplications : 4,6 fois plus lent. La division est presque deux fois plus lente ; - son bus de données fait 16 bits : lire ou écrire un
longen mémoire demande deux accès au lieu d'un.
Sur 68000, int et uint sont les types naturels ;
long se justifie quand la valeur dépasse 65 535, et pour les adresses (une
ressource de la Mega Drive est une adresse sur 32 bits, chapitre 11). ubyte
n'y fait rien gagner, et coûte parfois un peu plus, le temps d'être étendu.
En résumé
| Processeur | Le type le plus efficace | À éviter dans les boucles |
|---|---|---|
| 6502, HuC6280 | ubyte | ulong, multiplications, divisions |
| Z80 | uint (ou ubyte) | ulong, multiplications, divisions |
| 68000 | uint, int | long dans les multiplications et les divisions |
Dans tous les cas, les types non signés donnent le code le plus court quand la valeur ne peut pas être négative.
Les puissances de deux
Diviser par une puissance de deux (2, 4, 8, 16, 32…) revient à décaler
les bits vers la droite (chapitre 3), et prendre le reste revient à garder les bits du
bas. Simple8 le fait tout seul dès que le diviseur est une constante
puissance de deux. Mesuré sur C64, avec un uint :
| Opération | Cycles | Traduit par |
|---|---|---|
i / 40 | 768 | une routine de division |
i / 32 | 59 | 5 décalages |
i % 40 | 768 | une routine de division |
i % 32 | 1 | un « et » : i & 31 |
i * 40 | 82 | des décalages et des additions |
i * 32 | 62 | 5 décalages |
Diviser par 32 est 13 fois plus rapide que diviser par 40, et le reste par 32 ne coûte presque rien. D'où un conseil de conception : dimensionner en puissances de deux. Une carte de 64 colonnes plutôt que 60, des tableaux de 256 cases, des sprites de 16 × 16 pixels : les calculs d'indices deviennent gratuits.
Les types signés. Avec un int, qui peut être négatif, le
compilateur décale aussi, mais ajoute une correction pour arrondir vers zéro
(-7 / 4 vaut -1) : 88 cycles au lieu de 59 pour i / 32. Toujours
bien moins qu'une vraie division.
La page zéro et fast
Sur 6502 : la page zéro
Le 6502 atteint plus vite les 256 premiers octets de la mémoire, la page zéro.
fast y place une variable. Mais tout ne gagne pas autant :
| Mesuré sur C64 | Variable normale | Variable fast |
|---|---|---|
incrémenter un uint | 30 cycles | 29 cycles |
écrire par un pointeur, .p[i] = v | 32 cycles | 17 cycles |
Pour une variable ordinaire, la page zéro ne fait gagner qu'un cycle par accès. Pour un pointeur, elle divise presque le coût par deux : le 6502 ne lit par un pointeur que s'il est en page zéro, et un pointeur ordinaire doit y être recopié à chaque accès.
L'optimiseur s'en charge déjà
La page zéro est petite (206 octets disponibles sur C64, NES et PC Engine) et partagée
avec les bibliothèques. L'optimiseur de Simple8 y range de lui-même les
variables locales les plus utilisées dans les boucles, sans qu'on écrive
fast. Dans ce programme, aucune variable n'est déclarée fast :
uint f(uint x) {
    uint a = x * 2;
    uint b = a + 1;
    return b;
}
Pourtant, la table des symboles montre Main_f_a en $20 et
Main_f_b en $22 : en page zéro. Chaque variable déclarée
fast est donc un octet que l'optimiseur ne pourra plus donner à une variable
de boucle, souvent plus utile.
Selon le processeur
| Machine | Effet de fast |
|---|---|
| C64, NES, PC Engine (6502) | la page zéro : utile pour les pointeurs |
| Game Boy (SM83) | la mémoire haute, $FF80-$FFFE, atteinte par des instructions plus courtes |
| Amstrad CPC (Z80) | aucun : le Z80 n'a pas de zone plus rapide, la variable reste à la même adresse |
| Mega Drive, Amiga (68000) | aucun : toutes les variables sont déjà placées en $FFFF8000, que le 68000 atteint par une adresse courte de 16 bits |
Vers la disparition de fast
fast est une indication donnée à la main, et elle n'a de sens que sur
certains processeurs. L'optimiseur fait déjà mieux pour les variables locales : il
mesure leur usage, et choisit lui-même. Les prochaines versions de Simple8 doivent
étendre ce choix automatique à toutes les variables, et fast est appelé à
disparaître. D'ici là, réservez-le à trois cas :
- un pointeur parcouru dans une boucle ;
- une variable lue à chaque image par une interruption ;
- une variable qu'un bloc
_asmadresse en page zéro.
Économiser la mémoire
| Machine | Mémoire vive pour le programme |
|---|---|
| NES | 2 Ko (plus 8 Ko sur la cartouche, si elle en a) |
| PC Engine | 8 Ko |
| Game Boy | 8 Ko, plus 127 octets de mémoire haute |
| Commodore 64 | quelques Ko de variables, dans 64 Ko partagés avec le programme |
| Mega Drive | 64 Ko |
Quelques règles pour la ménager :
constne coûte pas de mémoire vive. Une constante, un tableau constant, une chaîne restent dans la ROM. Une table de 256 valeurs déclaréeconstéconomise 256 octets de RAM.- Une valeur de départ coûte deux fois.
ubyte t[100] = { … };prend 100 octets de RAM, et 100 de ROM pour les valeurs queboot.asmy recopie au démarrage (chapitre 3). Si le tableau ne change jamais, faites-en unconst. - Chaque variable locale a sa propre place. Les locales de deux fonctions ne partagent pas la même mémoire, même si les fonctions ne s'exécutent jamais en même temps : un grand tableau local dans une fonction rarement appelée occupe la RAM en permanence.
- Les contextes partagent leur mémoire (chapitre 8) : les variables d'un niveau n'occupent la RAM que pendant ce niveau.
- Regarder la place prise : le diagramme du projet de Simple8 IDE donne, pour chaque unit, la ROM, la RAM et la page zéro utilisées.
Les recettes
| Plutôt que… | Écrire… | Pourquoi |
|---|---|---|
| un calcul répété | une table const calculée d'avance | une lecture au lieu d'une multiplication (chapitre 10 : 8 fois plus rapide) |
| diviser par 40, 60, 100 | dimensionner en puissances de deux | 13 fois plus rapide |
writeMem(base + i, v) dans une boucle | un pointeur fast : .p[i] = v | pas de calcul d'adresse à chaque tour |
un ulong par précaution | le type du processeur : ubyte sur 6502, uint sur Z80 et 68000 | 3 à 8 fois moins cher |
| une fonction appelée dans une boucle serrée | son code écrit dans la boucle | chaque appel copie ses paramètres et saute |
| une fonction récursive | une boucle | pas de pile à gérer (chapitre 5) |
| tout recalculer à chaque image | ne recalculer que ce qui a changé | comme le chronomètre du chapitre 12, qui n'écrit les secondes que lorsqu'elles changent |
Lisible d'abord. Un programme clair se corrige et s'optimise facilement ; un programme optimisé partout devient illisible. Écrivez d'abord simplement, mesurez avec la bordure, puis optimisez les quelques endroits qui coûtent vraiment.
À retenir
- Tout doit tenir dans une image : mesurez avec la bordure avant d'optimiser.
- Le bon type dépend du processeur :
ubytesur 6502,uintsur Z80,int/uintsur 68000 ;longcoûte cher partout dans les multiplications et les divisions. - Diviser ou prendre un reste par une puissance de deux est presque gratuit : dimensionnez en puissances de deux.
fastne sert vraiment que sur 6502, surtout pour les pointeurs ; l'optimiseur place déjà les variables les plus utilisées, etfastest appelé à disparaître.constne coûte pas de RAM ; une valeur de départ coûte en RAM et en ROM.
À vous de jouer
- Mesurez avec la bordure le coût d'une multiplication par 40, puis par 32.
Voir la solutionMasquer la solution
On reprend l'exemple et on ne change que la ligne du calcul : une multiplication au lieu d'une division. Pour que la bande soit bien visible, la boucle fait 100 tours au lieu de 20. Pour comparer, on compile trois versions :
* 40,* 32, et la boucle seule (.resultat = i + 1000;), qui donne le coût de tout ce qui n'est pas la multiplication.main() { vic.setBackgroundColor(vic.BLACK); while (1) { irq.waitFrame(); // attendre le début d'une image vic.setBorderColor(vic.RED); // la bordure en rouge pendant le calcul... for (uint i = 0; i < 100; i++) { .resultat = (i + 1000) * 40; } vic.setBorderColor(vic.BLACK); // ... puis en noir } }Mesuré dans l'émulateur du kit de test, entre les deux changements de couleur :
Calcul dans la boucle (100 tours) Cycles Lignes d'écran Par opération la boucle seule 4 954 78 * 4014 354 227 94 cycles * 3211 154 177 62 cycles La multiplication par 32 (cinq décalages) reste la plus rapide, mais l'écart n'est que de 1,5 fois, loin du rapport de 13 entre les deux divisions. La raison : multiplier par une constante ne demande pas de routine. Dans
asm/main.asm, Simple8 calcule 40 = 5 × 8 : deux décalages et une addition donnenti * 4 + i, puis trois décalages multiplient par 8. C'est la division qui coûte cher, pas la multiplication par une constante.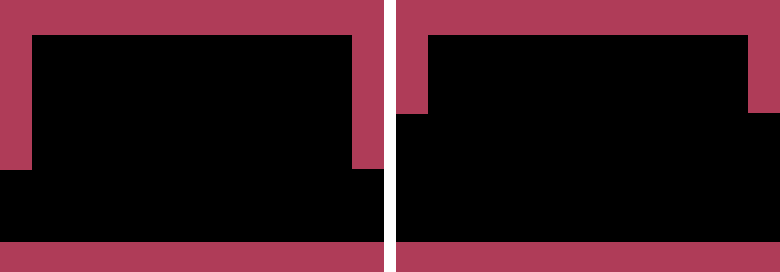
100 multiplications par 40 (à gauche) et par 32 (à droite), dans VICE. La bande commence en bas de l'écran, à l'interruption de l'image, et continue en haut de l'image suivante. - Diviser par 40 sert souvent à trouver la ligne d'une position de l'écran. Remplacez la division
de l'exemple par une table de 25 valeurs (le début de chaque ligne), et comparez la hauteur
des bandes.
Voir la solutionMasquer la solution
Dans un programme, diviser par 40 sert surtout à trouver la ligne d'une position de l'écran du C64 (40 colonnes, 25 lignes, positions de 0 à 999). On modifie donc l'exemple pour qu'il divise de vraies positions, de 0 à 950. La table de 25 valeurs contient le début de chaque ligne : 0, 40, 80… La ligne d'une position
nest la dernière dont le début ne dépasse pasn.Parcourir la table depuis la ligne 0 marche, mais ne gagne presque rien : jusqu'à 24 comparaisons de
uint, presque le prix de la division. L'astuce est de partir d'un point déjà proche :n >> 6, c'est-à-diren / 64, ne coûte que des décalages et n'est jamais plus grand quen / 40. Il reste au plus 9 pas à faire. Le testr < 24empêche de lire après la fin de la table.// le début de chaque ligne de l'écran : 0, 40, 80… (25 valeurs, en ROM) const uint DEBUT[] = { 0, 40, 80, 120, 160, 200, 240, 280, 320, 360, 400, 440, 480, 520, 560, 600, 640, 680, 720, 760, 800, 840, 880, 920, 960 }; uint resultat; main() { vic.setBackgroundColor(vic.BLACK); while (1) { irq.waitFrame(); // attendre le début d'une image vic.setBorderColor(vic.RED); // la bordure en rouge pendant le calcul... uint n = 0; // une position de l'écran, de 0 à 999 for (ubyte i = 0; i < 20; i++) { ubyte r = (ubyte)(n >> 6); // n / 64 : jamais plus que la vraie ligne while (r < 24 && n >= .DEBUT[r + 1]) { r++; // au plus 9 pas jusqu'à la bonne ligne } .resultat = r; // sa ligne, de 0 à 24 n = n + 50; } vic.setBorderColor(vic.BLACK); // ... puis en noir } } interrupt -> irq { }Mesuré pour 20 positions (le tour de boucle seul, sans calcul, prend 940 cycles) :
Méthode Cycles Lignes d'écran n / 4016 310 258 la table, parcourue depuis 0 14 320 227 la table, depuis n >> 67 294 115 La bande est un peu plus de deux fois moins haute. Un programme de contrôle, qui compare la méthode à
n / 40pour les 1 000 positions de l'écran, trouve 0 différence. La leçon : une table remplace un calcul quand on sait où y lire. Une table de 1 000 valeurs, lue directement parLIGNE[n], serait encore plus rapide, mais coûterait 1 000 octets ; celle-ci n'en prend que 50.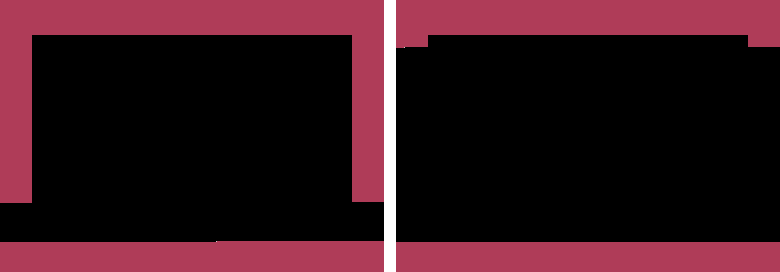
20 divisions par 40 (à gauche) et la table (à droite), dans VICE. - Compilez le même programme pour C64 et pour Amstrad CPC, en
ubytepuis enuint, et comparez le code deasm/main.asm.Voir la solutionMasquer la solution
Un programme court suffit, pourvu qu'il additionne, compare et incrémente. On le compile quatre fois, en changeant seulement l'architecture et le type (
ubyteici) :architecture commodore.c64; unit { ubyte total; main() { for (ubyte i = 0; i < 10; i++) { .total = .total + i; } } }Voici la fonction
maindeasm/main.asmdans chaque cas (les lignes; [Main:L8]rappellent la ligne du programme).Sur Commodore 64, en
ubyte; [Main:L7] Main_main__FOR_1_i = #0 LDA #<0 STA Main_main__FOR_1_i ; === Loop: _FOR_1 === _FOR_1_start: ; Loop condition: Main_main__FOR_1_i < #10 CMP #<10 BCS _FOR_1_end _loop1: ; [Main:L8] t0 = Main.total + Main_main__FOR_1_i LDA Main_total CLC ADC Main_main__FOR_1_i STA Main_total ; [Main:L8] Main.total = t0 ; Loop increment: Main_main__FOR_1_i++ INC Main_main__FOR_1_i ; Loop end: _FOR_1 LDA Main_main__FOR_1_i CMP #<10 BCC _loop1 _FOR_1_end:Sur Commodore 64, en
uint; [Main:L7] Main_main__FOR_1_i = #0 LDA #<0 STA Main_main__FOR_1_i STA Main_main__FOR_1_i+1 ; === Loop: _FOR_1 === _FOR_1_start: ; Loop condition: Main_main__FOR_1_i < #10 LDA Main_main__FOR_1_i+1 CMP #>10 BCC _FOR_1_cond_ok BEQ _FOR_1_cond_ok_skip1 JMP _FOR_1_end _FOR_1_cond_ok_skip1: LDA Main_main__FOR_1_i CMP #<10 BCC _FOR_1_cond_ok JMP _FOR_1_end _FOR_1_cond_ok: ; [Main:L8] t0 = Main.total + Main_main__FOR_1_i LDA Main_total CLC ADC Main_main__FOR_1_i STA Main_total LDA Main_total+1 ADC Main_main__FOR_1_i+1 ; [Main:L8] Main.total = t0 STA Main_total+1 ; Loop increment: Main_main__FOR_1_i++ INC Main_main__FOR_1_i BNE _FOR_1_incr_skip INC Main_main__FOR_1_i+1 _FOR_1_incr_skip: ; Loop end: _FOR_1 JMP _FOR_1_start _FOR_1_end:Sur 6502, tout double : l'addition se fait en deux fois, octet bas puis octet haut (le second
ADCajoute la retenue du premier) ; la comparaison avec 10 teste d'abord l'octet haut, puis l'octet bas ; l'incrémentation doit propager la retenue (INC,BNE,INC).Sur Amstrad CPC, en
ubyte; [Main:L7] Main_main__FOR_1_i = #0 LD A,0 LD (Main_main__FOR_1_i),A _FOR_1_start: ; Loop condition: Main_main__FOR_1_i < #10 LD A,10 LD B,A LD A,(Main_main__FOR_1_i) CP B JP NC,_FOR_1_end ; [Main:L8] t0 = Main.total + Main_main__FOR_1_i LD A,(Main_total) LD L,A LD H,0 LD A,(Main_main__FOR_1_i) LD E,A LD D,0 ADD HL,DE LD (t0),HL ; [Main:L8] Main.total = t0 LD A,(t0) LD (Main_total),A ; Loop increment: Main_main__FOR_1_i++ LD HL,Main_main__FOR_1_i INC (HL) JP _FOR_1_start _FOR_1_end:Sur Amstrad CPC, en
uint; [Main:L7] Main_main__FOR_1_i = #0 LD A,0 LD (Main_main__FOR_1_i),A LD A,0 LD (Main_main__FOR_1_i+1),A _FOR_1_start: ; Loop condition: Main_main__FOR_1_i < #10 LD HL,(Main_main__FOR_1_i) LD DE,10 OR A SBC HL,DE JP NC,_FOR_1_end ; [Main:L8] t0 = Main.total + Main_main__FOR_1_i LD HL,(Main_total) LD DE,(Main_main__FOR_1_i) ADD HL,DE LD (t0),HL ; [Main:L8] Main.total = t0 LD HL,(t0) LD (Main_total),HL ; Loop increment: Main_main__FOR_1_i++ LD HL,(Main_main__FOR_1_i) INC HL LD (Main_main__FOR_1_i),HL JP _FOR_1_start _FOR_1_end:Sur Z80, c'est l'inverse pour l'addition : en
uint, elle tient en trois instructions (LD HL,LD DE,ADD HL,DE) ; enubyte, chaque valeur doit d'abord être étendue à 16 bits (LD H,0,LD D,0) avant la mêmeADD HL,DE, puis le résultat est ramené à un octet. La comparaison et l'incrémentation, elles, restent plus courtes enubyte(CP,INC (HL)).Mesuré dans les émulateurs du kit de test (le programme moins un programme vide), et en taille du code de
main:C64, ubyteC64, uintCPC, ubyteCPC, uintTemps des 10 tours 281 cycles 584 cycles 1 884 états 2 602 états Taille de main25 octets 52 octets 44 octets 49 octets Sur C64, passer en
uintdouble le temps et la taille. Sur CPC, la taille ne change presque pas, et l'addition elle-même devient plus simple ; dans cette boucle, la comparaison et l'incrémentation d'un compteur 16 bits rendent pourtant l'ensemble 1,4 fois plus lent. Le Z80 n'a pas de préférence aussi nette que le 6502 : il faut regarder le code. - Cherchez dans le diagramme du projet de l'IDE l'unit qui prend le plus de RAM, et
réduisez-la avec
const.Voir la solutionMasquer la solution
Le diagramme du projet affiche, pour chaque unit, ce que le compilateur écrit dans
asm/main_units.json: ROM, RAM et page zéro. On peut donc faire l'exercice dans l'IDE, ou en lisant ce fichier. Les exemples du cours déclarent déjà leurs tables enconst; voici un petit programme qui ne le fait pas : une unitNiveauavec une carte de 8 lignes de 32 cases, et deux petites tables pour la dessiner.// Niveau.s8u : une carte de 8 lignes de 32 cases unit Niveau { ubyte carte[256] = { 1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1, 1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,1, 1,0,2,2,2,2,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,2,2,2,2,0,1, 1,0,0,0,0,0,0,0,0,0,0,3,3,3,3,3,3,3,3,3,3,0,0,0,0,0,0,0,0,0,0,1, 1,0,0,0,0,0,0,0,0,0,0,3,0,0,0,0,0,0,0,0,3,0,0,0,0,0,0,0,0,0,0,1, 1,0,2,2,2,2,0,0,0,0,0,3,3,3,3,3,3,3,3,3,3,0,0,0,0,0,2,2,2,2,0,1, 1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,1, 1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1 }; ubyte couleurs[4] = { 0, 14, 7, 2 }; // vide, mur, bonus, piège ubyte dessins[4] = { ' ', '#', '*', '+' };Le diagramme (et
main_units.json) donne, pourNiveau:"rom": 355, "ram": 264. C'est l'unit qui prend le plus de RAM, de loin :Mainn'en prend aucune. Les 264 octets sont les trois tableaux (256 + 4 + 4). Ils ont une valeur de départ, donc ils existent deux fois : en RAM, et dans le programme, d'oùboot.asmles recopie au démarrage.Or
dessiner()ne fait que lire ces tableaux. On les déclare doncconst, avec un nom en majuscules comme les autres constantes du cours, et la taille entre crochets n'est plus nécessaire :unit Niveau { const ubyte CARTE[] = { 1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1, // … 1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1,1 }; const ubyte COULEURS[] = { 0, 14, 7, 2 }; // vide, mur, bonus, piège const ubyte DESSINS[] = { ' ', '#', '*', '+' }; void dessiner() { uint n = 0; for (ubyte y = 0; y < 8; y++) { vic.setCursor(4, (ubyte)(y + 8)); for (ubyte x = 0; x < 32; x++) { ubyte c = .CARTE[n]; vic.setFontColor(.COULEURS[c]); vic.putChar(.DESSINS[c]); n++; } } } }Résultat :
"rom": 355, "ram": 0. Les 264 octets de RAM sont libérés, la ROM ne change pas (les valeurs y étaient déjà), et le fichiermain.prgperd même 18 octets : la table de recopie du démarrage n'a plus rien à recopier. L'écran est identique au pixel près (captures de VICE comparées).Si un jour le jeu doit modifier la carte (une brique cassée, par exemple), elle ne peut plus être
const. On garde alors la carte d'origine enconst, et on ne met en RAM que ce qui change, commeJeu.briquesau chapitre 14.